Хочу начать с цитаты Джоша Берсина: компенсации — одна из самых мощных и одновременно наименее понятых коммуникационных функций в компании. Я согласен с этим полностью. Через компенсации проходят деньги, а деньги напрямую влияют на мотивацию, на решение остаться или уйти, на то, считает ли человек себя ценным. И при этом мало кто в бизнесе умеет этой силой пользоваться осознанно.
Долгое время причина была банальной: чтобы управлять компенсациями по-взрослому, нужно было либо построить отдельный отдел, либо нанять консалтинговую компанию. Методологии оценки должностей стоили денег, обзоры рынка стоили денег, эксперт, который умеет всё это собрать в систему, стоил ещё больше. Компании без бюджета просто жили без грейдинга, без вилок, без прозрачных правил — и получали весь набор последствий.
Сегодня ситуация изменилась радикально. Искусственный интеллект знает все ключевые методологии оценки должностей, умеет работать с массивами данных, умеет держать в голове контекст вашей компании и выдавать результат уровня консультанта. Я много лет занимался компенсациями и льготами на телеканале СТБ и в компании Wargaming: грейдинг, обзоры рынка зарплат, построение системы бенефитов, аудит EVP, бюджетирование и пересмотр зарплат, разработка систем премирования. И могу сказать честно: то, на что у меня уходили недели, сейчас делается за часы. В этой статье я разберу первый и самый фундаментальный блок — архитектуру должностей и грейдинг с помощью искусственного интеллекта.
Почему C&B застрял в Excel и почему это больше не работает
Функция Compensation & Benefits исторически очень тесно дружила с Excel. Там хранились зарплаты, там считалась аналитика, там планировались пересмотры, там же жил грейдинг. Кто работал в Total Rewards, тот помнит эти бесконечные ВПР, ИНДЕКС, сводные таблицы, которые ломаются от одного добавленного столбца, и ощущение, что половина рабочего времени уходит на то, чтобы формула перестала выдавать ошибку.
Я не призываю отказываться от Excel. Excel остаётся отличным носителем информации и удобным способом её хранить и передавать. Но продолжать жить только в Excel — это вчерашний день. К таблицам должен добавиться искусственный интеллект, который берёт на себя мышление, а не только вычисления.
Есть ещё один эффект, который я на себе почувствовал. Когда ты знаешь, что задачу можно решить с ИИ не хуже, чем вручную, и всё равно делаешь её вручную, ты физически ощущаешь, как тратишь время впустую. Для маленькой компании на 50 человек ещё можно представить жизнь без ИИ. Для крупной — выбора уже нет.
510 часов в год: сколько на самом деле стоит ручной Total Rewards
Давайте посчитаем, сколько времени съедает функция C&B за год, если делать всё руками. По моей оценке, полный цикл типовых задач — это около 510 часов в год, то есть примерно три месяца работы одного человека в режиме full-time.
И это, обратите внимание, ещё не все задачи. Сюда не вошли разработка систем премирования, анализ того, как эти системы реально работают, разбор точечных пересмотров зарплат за год, подготовка выводов и рекомендаций. Если добавить их, счёт легко уходит далеко за 510 часов.
Отдельно стоит посмотреть на строку с Total Rewards Statement. 250 часов — это половина всего бюджета времени функции, потраченная на документ, который в большинстве компаний вообще не делается именно потому, что «нет ресурса».
Отдельно стоит посмотреть на строку с Total Rewards Statement. 250 часов — это половина всего бюджета времени функции, потраченная на документ, который в большинстве компаний вообще не делается именно потому, что «нет ресурса».
Что теряет компания без зрелого Total Rewards
Отсутствие системы — это не нейтральное состояние. Это набор конкретных потерь, которые я вижу в компаниях постоянно:
•Разрыв в оплате 20% и больше. Речь о разнице в зарплатах между мужчинами и женщинами в среднем по индустрии, уже после контроля за уровнем должности и стажем. То есть это не объясняется «они на других позициях» — это чистый разрыв.
•В полтора раза выше текучесть топ-перформеров по сравнению с компаниями, где Total Rewards выстроен прозрачно и где сотрудник понимает, из чего складывается его вознаграждение.
•62% провальных salary review. Сотрудники после плохо организованного пересмотра говорят, что их недооценили, и уходят. Причём часто уходят не из-за суммы, а из-за того, как процесс был проведён и объяснён.
Получается простой выбор: либо жить с этими потерями, либо нанимать большой отдел и консультантов, либо научиться использовать искусственный интеллект.
25 часов вместо 510: как выглядит функция на AI
Ключевое здесь — не экономия часов сама по себе, а то, во что эти часы конвертируются. Когда pay equity считается по запросу, а не раз в год, вы можете подсветить проблему до того, как она станет юридическим и репутационным кейсом. Когда 500 персонализированных заявлений о вознаграждении делаются за час, они начинают существовать не только для топ-менеджмента, а для всей компании.
Фреймворк TRACE: пять уровней зрелости Total Rewards
Путь построен вокруг модели, которую я назвал TRACE. Логика в том, что каждый следующий уровень опирается на предыдущий, и перепрыгнуть через ступеньку нельзя.
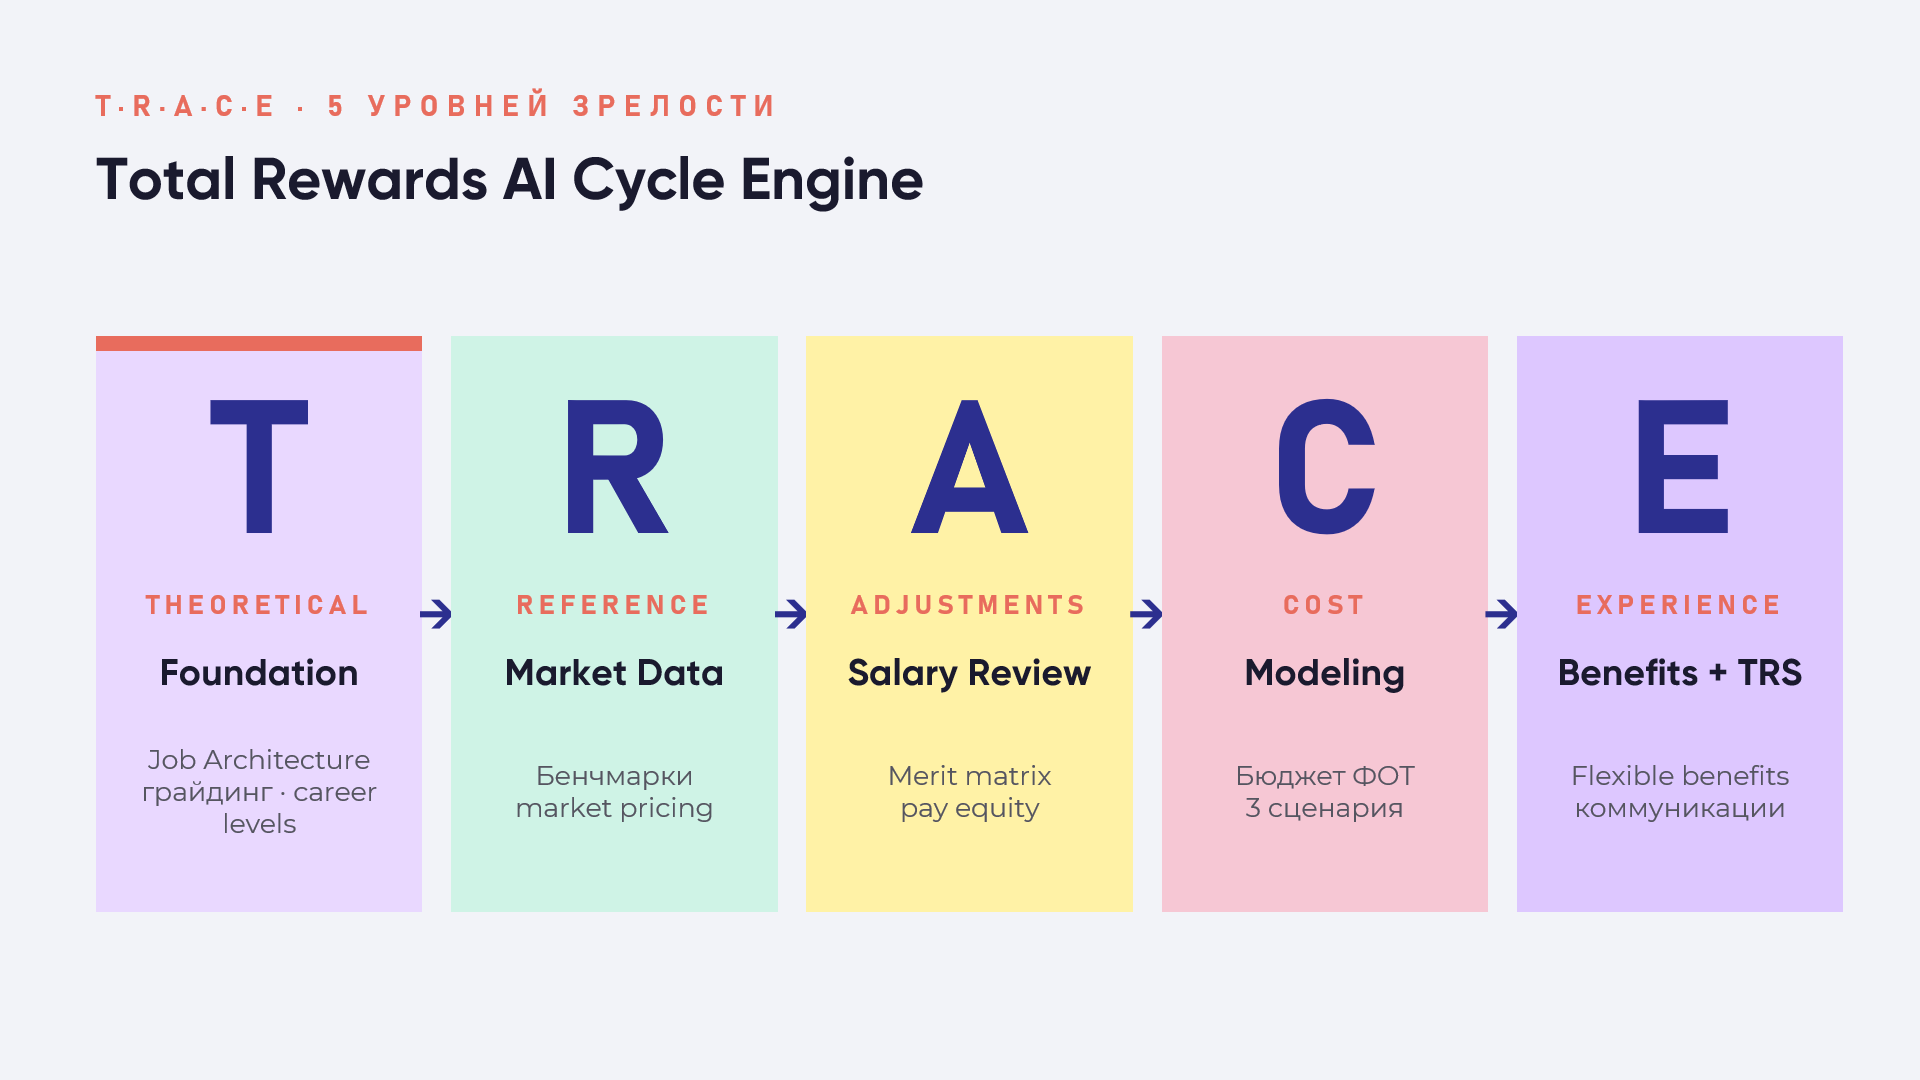
Разберу логику подробнее. Если у вас нет архитектуры должностей, бенчмарк ломается сразу: вы сравниваете своих сеньоров непонятно с чем, получаете медиану рынка, которая ниже ваших фактических выплат, и не понимаете, что с этим делать. Дальше — рыночные данные, где источниками выступают и платные обзоры провайдеров, и открытые данные, и то, что модель уже знает. Здесь есть важный нюанс: ИИ обучен на таком массиве, что часть знаний в открытом интернете вы просто не найдёте, а часть лежит в таких углах, куда вы никогда не заглядывали.
Затем идёт пересмотр зарплат, потом моделирование затрат — потому что нельзя ставить вилки и планировать повышения, не понимая, как это превращается в бюджет. И финал цикла — Total Rewards Experience: как сделать так, чтобы вознаграждение учитывало потребности разных людей и реально на них влияло. Вот это как раз то, что без ИИ было практически недоступно.
Затем идёт пересмотр зарплат, потом моделирование затрат — потому что нельзя ставить вилки и планировать повышения, не понимая, как это превращается в бюджет. И финал цикла — Total Rewards Experience: как сделать так, чтобы вознаграждение учитывало потребности разных людей и реально на них влияло. Вот это как раз то, что без ИИ было практически недоступно.
Уровень T: что такое архитектура должностей
Архитектура должностей — это системная организация всех позиций компании в единой структуре. Она состоит из трёх слоёв:
Job Families — семейства должностей
Группы ролей по типу деятельности: инжиниринг, продукт, дизайн, продажи, маркетинг, HR, финансы, операции или производство. Набор зависит от индустрии — у продуктовой компании он будет один, у производственной другой.
Career Levels — карьерные уровни
Уровни внутри каждого семейства, сквозные для всей компании. Например, от IC1 до IC8 для индивидуальных контрибьюторов и M3–M7 для менеджеров. Сквозные — ключевое слово: уровень 5 в инжиниринге и уровень 5 в финансах должны означать сопоставимую сложность и влияние.
Job Profiles — профили должностей
Конкретная роль в конкретном семействе на конкретном уровне, со своим описанием, скоупом и impact. Например, senior backend engineer уровня 5 — это уже job profile.
Многие компании дополнительно разделяют функциональные треки: отдельно individual contributors, отдельно менеджеры. Это база всего цикла Total Rewards. Раньше её построение занимало месяцы и требовало консультантов, которые приносили свою методологию и либо мэтчили ваши должности со своим каталогом, либо строили уникальную структуру под вас.
Двойная карьерная лестница: как это устроено в технологических компаниях
В технологических компаниях распространена модель с восемью уровнями должностей, где экспертный и менеджерский треки идут параллельно. Смысл в том, что сотрудник на любом этапе может выбрать, развиваться ему вглубь экспертизы или в people-менеджмент, и ни один из путей не считается выше другого.
Подобную архитектуру используют провайдеры данных, например Radford. И самое главное: модель эта известна искусственному интеллекту, поэтому построить аналогичную структуру под свою компанию можно за один рабочий день.
Методологии оценки должностей, которые знает Claude
Методологии нужны для того, чтобы оценить должность, распределить позиции по грейдам, а затем установить для грейдов вилки. Вот основные, которые используются в мире:
Плюс существуют локальные и региональные методологии от менее известных провайдеров — их тоже можно использовать, если они распространены на вашем рынке.
Как устроена методология Hay
При оценке должности по Hay вы смотрите на три вещи:
1.Требуемый уровень знаний для этой должности.
2.Уровень решаемых проблем и вопросов — насколько сложные и неструктурированные задачи закрывает роль.
3.Ответственность — на что и в каком масштабе роль влияет.
По каждому фактору должность получает баллы, баллы суммируются, из суммы выводится грейд и карьерный уровень.
Мой опыт: $10,000 за методологию и два дня тренинга
Когда я работал на телеканале СТБ, мы хотели навести порядок в должностях. Вариантов было два: нанимать компанию Hay, что было дорого, или искать обходной путь. Дело происходило после мирового финансового кризиса 2008–2009 годов, когда на рынке оказалось много сокращённых специалистов, включая консультантов по грейдингу и построению архитектуры должностей.
Мы поступили прагматично: наняли не компанию, а консультантов, которые раньше в ней работали. Они прочитали для нас двухдневный тренинг, немного проконсультировали, и дальше мы оценивали должности сами. Даже в таком экономном варианте мы заплатили около 10 000 долларов.
Сегодня я не отговариваю никого от найма консультантов — если бюджет есть, это хорошая опция. Но если бюджета нет, у вас теперь есть альтернатива. Claude знаком с методологиями: он знает принципы, факторы, логику баллов. Всё, что нужно сделать вам, — загрузить свои данные, корректно поставить задачу и понимать, какой результат вы ждёте на выходе.
Ещё один живой пример — компания Preply, сегодня технологический единорог. Когда она была маленькой, построение архитектуры должностей, зарплатных вилок и оценка позиций занимали очень много времени: часть делал я, часть — мой people operations менеджер. Сейчас тот же объём работы делается в разы быстрее, а точность при этом не ниже.
Почему Claude, а не ChatGPT: сравнение для задач C&B
Я зарегистрировался в ChatGPT сразу, как он появился, и пользовался им несколько лет. Потом перешёл на Claude, хотя ChatGPT иногда использую до сих пор. Вот сравнение по параметрам, которые важны именно для Total Rewards.
На простых задачах разницы почти нет: попросите оба инструмента написать текст вакансии — результат будет сопоставимым. Разница проявляется на сложных задачах, где нужно удержать много данных и нюансов одновременно.
Кейс: отчёт по EVP в Wargaming
У меня был большой опросник по EVP в Wargaming: около 1 500 строк и порядка 150 столбцов. Обрабатывал я его вручную почти в режиме full-time около недели. Помню, что мне снились таблицы: закрываешь глаза — и видишь заливку цветом, цифры, формулы.
Когда появился Claude, я взял сырую выгрузку того самого отчёта и загрузил её сразу в четыре инструмента: Claude, ChatGPT, Gemini и Grok. Попросил сделать отчёт. Claude справился идеально — он охватил весь массив, проанализировал и выдал результат. ChatGPT и Gemini справились хуже. Отдельно отмечу Gemini: он оказался самым «ленивым» — иногда в ответ на задачу он предлагает мне Python-скрипт, который я должен где-то запустить, чтобы задача решилась. То есть он делегирует мою задачу обратно мне.
Как собрать Claude Project «C&B Job Architecture» за 90 минут
Проект в Claude — это рабочее пространство, где живут ваша база знаний, инструкции и все чаты по теме. По сути вы создаёте персонального AI-агента, эксперта в Total Rewards.
1.Создайте проект. В левом меню Projects → New Project. Назовите его, например, Job Architecture.
2.Пропишите системный промт (Project Instructions). Здесь вы задаёте роль агента, его экспертизу, принципы работы, ограничения.
3.Загрузите базу знаний. Это файлы, на которые агент будет опираться.
4.Задайте стиль и формат вывода. В каком виде вы хотите получать ответы: таблица, карточка оценки, краткое резюме.
5.Протестируйте и донастройте. Прогоните несколько должностей и сравните результат со своим пониманием.
Полезная деталь: если внутри проекта вы обсуждаете что-то ценное, Claude сохраняет это в память проекта и использует в других чатах. Инсайты из одного диалога переносятся в следующие.
Что загружать в базу знаний
•Методологии, если они у вас есть. Документы Hay или Mercer — их интеллектуальная собственность, поэтому я не могу передавать их в рамках курса и могу только ссылаться на них. Но если у вас ничего нет — не страшно: модель обучена на этих методологиях, и я тестировал это в разных сценариях.
•Ваши должностные инструкции — хотя бы 10–20 штук. Чем больше загрузите, тем лучше модель поймёт вашу специфику и то, как у вас принято описывать роли.
•Организационная структура — список ролей, отделов, отношений подчинения. Фамилии можно не загружать: это вопрос конфиденциальности и требований GDPR, если вы в Европе. Решение о загрузке персональных данных всегда остаётся за вами.
•Обзор рынка заработных плат, если он есть. Если нет — не критично, открытые источники мы разбираем на втором занятии.
•Внутренняя специфика: ваши названия, термины, принятые обозначения. Если это нигде не описано, просто напишите или надиктуйте и сохраните в знаниях проекта.
Структура промта для оценки должности
Хороший промт для C&B держится на четырёх элементах:
1.Роль — как ведёт себя агент, кем он является в этом диалоге.
2.Контекст — описание компании, индустрии, специфики. Может лежать в базе знаний.
3.Инструкция — что именно вы оцениваете и по какой методологии.
4.Структура ответа — в каком виде вы хотите получить результат.
На таком каркасе строятся все типовые задачи: посчитать баллы по методологии Hay для senior backend engineer и выдать готовый текст для копирования, оценить сразу 10 ролей одним промтом, провести калибровку, сгенерировать список семейств должностей под вашу компанию, построить карьерную архитектуру с поведенческими индикаторами.
Цикл доводки проекта до рабочего состояния за 7 дней
Первый результат почти никогда не будет идеальным, и это нормально. Вот последовательность, которая приводит проект в рабочее состояние:
1.Прогоните пять ролей разных уровней — обязательно разных, чтобы увидеть, как модель различает сложность.
2.Сравните оценки с тем, как вы сами оценили бы эти позиции, и с данными, которые у вас уже есть.
3.Поправьте инструкции там, где логика разошлась с вашей.
4.Дополните базу знаний недостающим контекстом.
5.Прогоните сложные, пограничные кейсы — именно на них видно качество настройки.
6.Протестируйте с командой: пусть коллеги проверят результат на своих ролях.
7.Зафиксируйте финальную версию как рабочий стандарт проекта.
Отдельный приём, которым я пользуюсь постоянно: если модель сделала не то, что я ожидал, я прошу её провести ретроспективу. «Почему у тебя получилось именно так?» Она объясняет. «Что нужно изменить, чтобы получалось вот так?» Она формулирует. Этот ответ я добавляю в знания проекта — и следующий прогон уже корректный.
Инструменты и шаблоны
Кроме промтов, в работе помогают готовые файлы. Структура файла оценки простая: первая вкладка — инструкции, дальше таблицы методологии, мэппинг и шаблон карточки должности, где вы проставляете варианты ответов, а баллы суммируются в total score, hay grade и career level. Есть заполненный пример для senior backend engineer и лист массового сравнения для большого количества позиций.
С этими файлами можно работать двумя способами: заполнять руками или отдать шаблон Claude вместе со своими должностными инструкциями и попросить заполнить его под вашу компанию.
Если вы смотрите в сторону готовых платных решений, на рынке есть Pave, HR Signal и beqom. Они дорогие, и мой аргумент всегда в пользу связки «Claude + шаблоны»: результат вы получите не хуже, а стоить это будет несопоставимо меньше.
Что делать дальше
1.Соберите исходники. Выгрузите 10–20 должностных инструкций и организационную структуру без персональных данных.
2.Создайте проект в Claude под названием, например, C&B Job Architecture, и пропишите системный промт с ролью эксперта в Total Rewards.
3.Определите семейства должностей и карьерные уровни для своей компании: сколько уровней IC, сколько менеджерских, где они синхронизированы.
4.Прогоните пять разных ролей через оценку по выбранной методологии и сравните с собственной экспертной оценкой.
5.Проведите ретроспективу расхождений вместе с моделью и добавьте выводы в базу знаний проекта.
6.Соберите архитектуру целиком — семейства, уровни, профили должностей — и зафиксируйте её в шаблоне.
7.Настройте метрики, по которым вы будете отслеживать качество грейдинга и управления архитектурой должностей.
Формула 10/20/70: сколько знаний вам реально нужно
Раньше, чтобы работать в Total Rewards, нужно было обладать практически стопроцентной экспертизой — направление сложное, методологичное, с большим количеством нюансов. Сейчас пропорция другая:
1.10% — ваши знания C&B и Total Rewards. Достаточно понимать логику направления и то, какой результат вы хотите получить на выходе.
2.20% — умение работать с искусственным интеллектом. Это про промтинг, про проекты, про базу знаний, про то, как проверять и донастраивать модель.
3.70% — работа самого искусственного интеллекта. Он знает методологии, помнит рыночные практики, считает, структурирует, оформляет.
Именно поэтому курс AI для C&Bи TotalRewards.Из аналитика — в партнера полезен и новичкам, и опытным специалистам. Начинающие попутно осваивают само направление Total Rewards, а опытные сразу видят, как переложить знакомые процессы на новые инструменты.
✅ На курсе AI для C&Bи TotalRewards.Из аналитика — в партнера используются шаблоны в Excel: построитель архитектуры должностей, инструмент для оценки должностей по методологии Hay и руководство по применению.